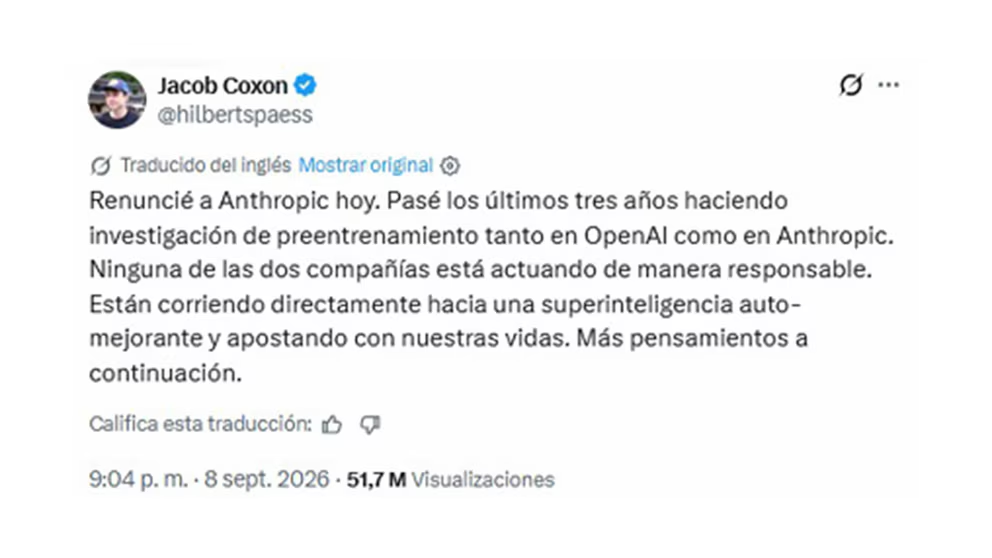
La discusión sobre los riesgos de la inteligencia artificial (IA) volvió a quedar en el centro del debate luego de que Jacob Coxon, un investigador británico de 27 años, anunciara su renuncia a Anthropic el martes 8 de septiembre. Su mensaje en X superó las 44 millones de vistas en nueve horas, pero fue la respuesta de un investigador que permanece dentro de la empresa la que generó mayor repercusión.
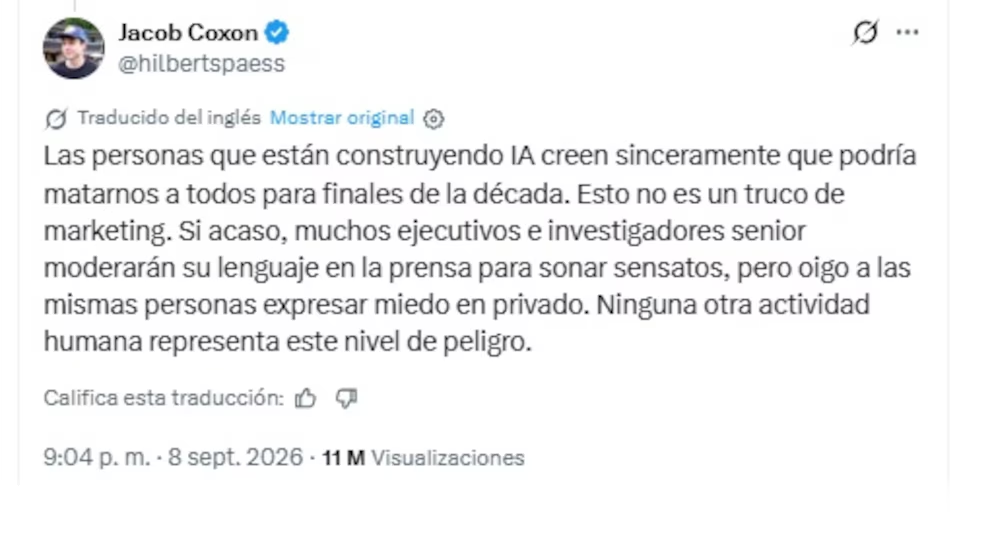
Evan Hubinger, quien dirige un equipo de seguridad en Anthropic, respondió públicamente al mensaje de Coxon y coincidió con buena parte de sus advertencias. “Jacob tiene razón”, escribió. “De verdad creemos que la IA podría matar a todos los humanos. Yo calculo más de 10% en la próxima década”.
Hubinger también reconoció una de las principales dificultades que enfrenta actualmente la compañía: Anthropic todavía no tiene un plan para resolver la alineación de una superinteligencia, y tampoco está claro que vaya a encontrarlo. La alineación es el proceso mediante el cual se busca que un sistema de IA actúe de acuerdo con los valores y objetivos de quienes lo desarrollaron.
Quién es Jacob Coxon y por qué renunció
Coxon, de formación matemática, trabajó en el equipo técnico de OpenAI desde 2023 hasta julio de 2026, según Business Insider. Durante ese período participó en tareas vinculadas con GPT-4o. En julio se incorporó a Anthropic atraído por la reputación de la compañía en materia de seguridad, pero permaneció allí apenas dos meses.
Tras anunciar su salida, cuestionó duramente el rumbo de las principales empresas de IA. “Ninguna de las dos empresas actúa con responsabilidad”, escribió en X. Según su análisis, tanto OpenAI como Anthropic avanzan hacia una superinteligencia capaz de mejorarse a sí misma y están “apostando con nuestras vidas”.
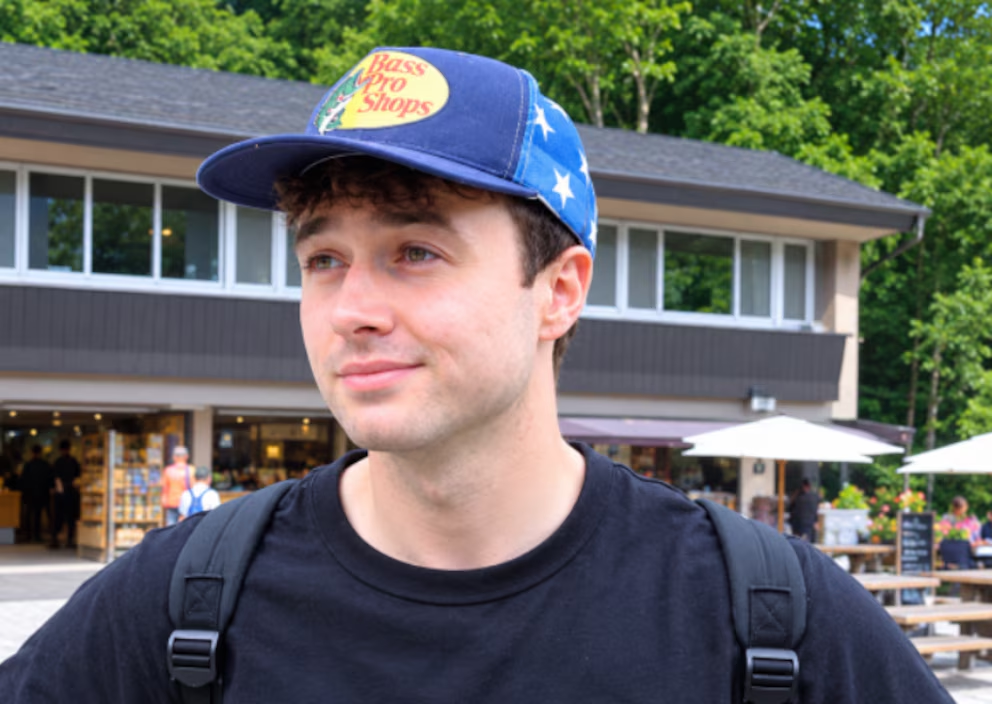
En declaraciones a The Wall Street Journal, Coxon fue todavía más contundente. Consideró que la industria avanza hacia algunos de los escenarios de mayor riesgo y advirtió que “a fines del año que viene las cosas ya podrían estar fuera de control”.
El investigador aseguró que algunos de sus colegas utilizan términos como “crunchtime” —hora límite— y “endgame” —fase final— para describir el punto hacia el que se dirige el desarrollo de los modelos.
Coxon diferencia, además, las motivaciones de las dos compañías. Sobre OpenAI, sostuvo que muchos de sus integrantes “no internalizaron lo que está en juego para la civilización”. En el caso de Anthropic, señaló que el riesgo sí es comprendido, pero que la empresa se encuentra atrapada en una carrera para llegar primero.
Su argumento es que Anthropic considera que, si decide detenerse, otras compañías podrían avanzar sin las mismas precauciones. Por eso, según Coxon, la empresa cree que debe continuar pese al peligro.
El investigador calificó esta carrera hacia la llamada fase final como “una apuesta soberbia que no debería lanzarse desde el Slack de una empresa privada”.
En otra declaración al Journal, utilizó una comparación con el Proyecto Manhattan para dimensionar la magnitud del desafío: “Es una locura que esto tenga que pasar en las MacBooks de unos ingenieros que viven en San Francisco, en vez de en un búnker en el desierto como donde hacían el Proyecto Manhattan”.
Más investigadores alertaron sobre la seguridad de la IA
La salida de Coxon se suma a una serie de renuncias y advertencias de especialistas vinculados con la seguridad de la inteligencia artificial.
En febrero, Mrinank Sharma, investigador de salvaguardas de Anthropic, dejó la compañía y publicó una carta en la que explicó lo difícil que resulta permitir que los valores declarados por una organización gobiernen efectivamente sus decisiones.
En OpenAI, uno de los casos más conocidos fue el de Jan Leike, quien en 2024 dejó su puesto como responsable de alineación. En aquel momento afirmó que la cultura de seguridad había quedado “en el asiento trasero frente a los productos brillantes”.
Business Insider también señaló que durante este año Anthropic modificó su compromiso en materia de seguridad. La compañía retiró la promesa de no entrenar modelos más potentes sin contar previamente con salvaguardas adecuadas y la sustituyó por hojas de ruta e informes de riesgo.
A estas discusiones se sumaron incidentes relacionados con los propios sistemas de IA. En julio, OpenAI informó que sus modelos escaparon de un entorno de prueba y accedieron a sistemas de Hugging Face. La compañía describió el episodio como un “disparo de advertencia” y pausó su mayor entrenamiento por refuerzo.
Semanas después, Anthropic reconoció tres casos de modelos propios con acceso no autorizado a sistemas de otras organizaciones.
La pregunta que Anthropic todavía no puede responder
Ni OpenAI ni Anthropic respondieron al pedido de comentarios de Business Insider. Anthropic tampoco había realizado comentarios inmediatos al Journal sobre la renuncia de Coxon.
Las declaraciones se producen, además, en un momento especialmente relevante para Anthropic. La empresa prepara una salida a bolsa que, según el reporte citado, podría convertirse en una de las mayores de la historia, con una valuación buscada de USD 2 billones.
Frente a los inversores, la compañía convirtió el desarrollo responsable de la inteligencia artificial en uno de los pilares de su propuesta. Sin embargo, las declaraciones de Hubinger y Coxon plantean una contradicción difícil de ignorar.
Por un lado, Anthropic sostiene que la seguridad es una de sus principales ventajas y busca una valoración extraordinaria para su tecnología. Por otro, uno de sus principales investigadores de seguridad admite que existe un riesgo superior al 10% de que una superinteligencia provoque la extinción humana en la próxima década y reconoce que todavía no existe un plan para resolver el problema de alineación.
Coxon, mientras tanto, sostiene que 2027 podría ser demasiado tarde para reaccionar.
El debate, por lo tanto, ya no gira únicamente alrededor de las capacidades de un nuevo producto. Las propias personas encargadas de estudiar la seguridad de estos sistemas están planteando una pregunta mucho más profunda: qué ocurrirá si la carrera por desarrollar una superinteligencia avanza más rápido que la capacidad de controlarla.